TaskExtraction · работа с задачами в Telegram
ИИ, который не разговаривает. За это я его и взял
Я не хотел, чтобы нейросеть мне что-то писала. Мне нужен был один ответ: это задача или нет? А она писала JSON. С объяснением. И с уверенностью «0.9», которую придумала сама.
Попробовать TaskExtraction
Что было не так
Первый классификатор в TaskExtraction — обычная LLM с промптом «верни только JSON»: задача ли это, уверенность, причина.
Работало. Но уверенность в таком ответе — просто цифра, написанная текстом.
Поэтому сверху появились эвристики: глаголы действия, сроки, упоминания. Их оценка смешивалась с ответом модели — 35 на 65.
Костыль поверх костыля.
Модель, которая не пишет текст
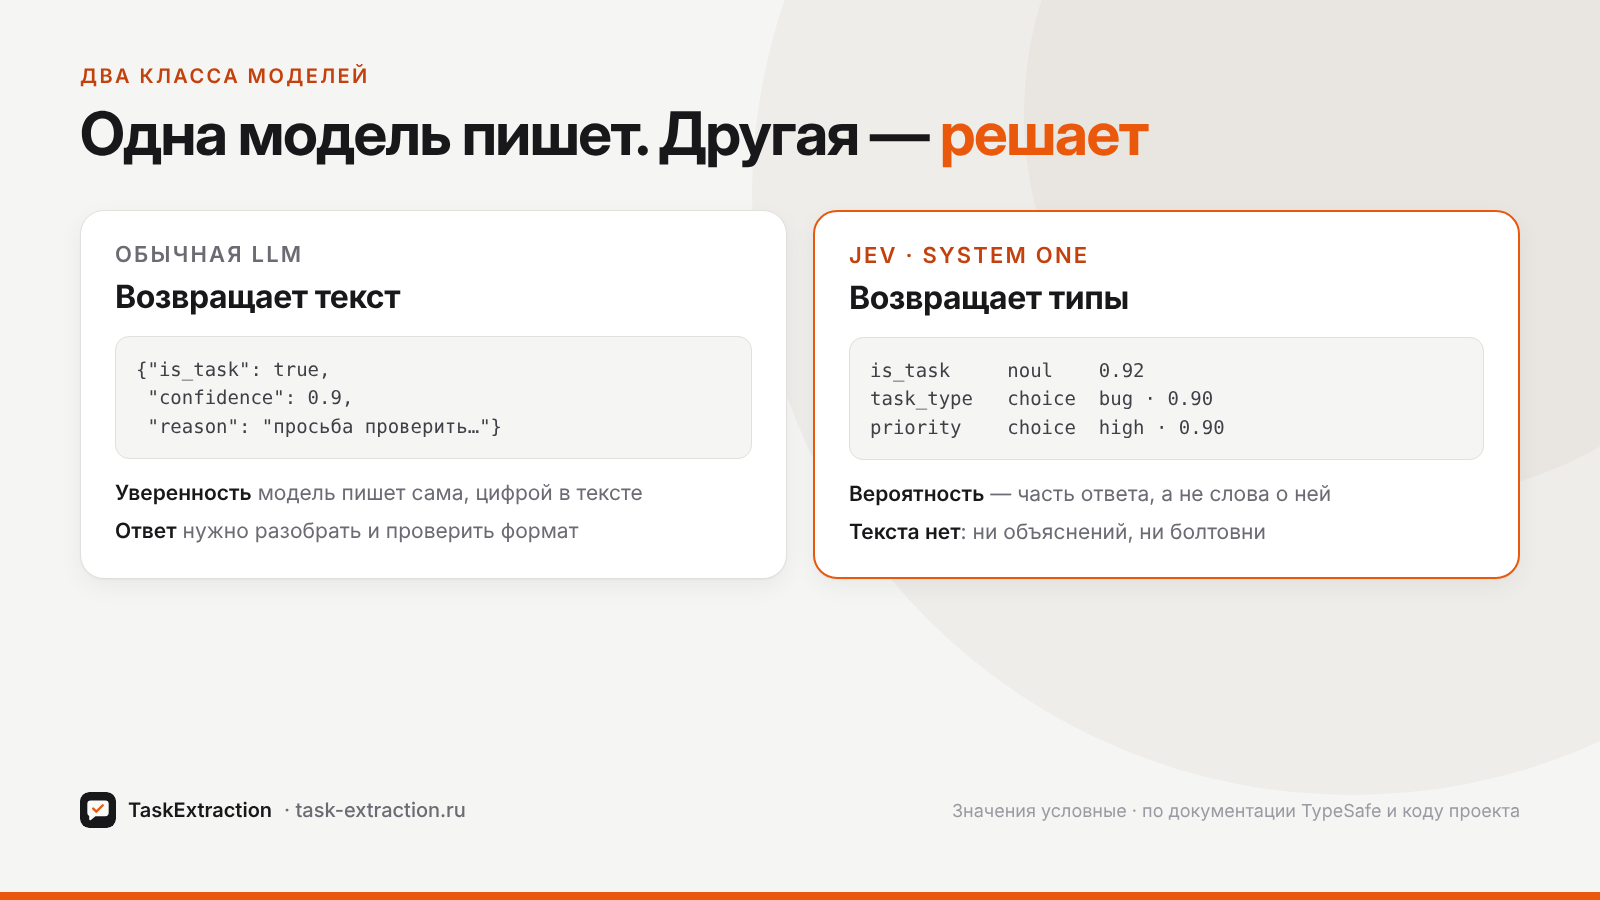
Jev от TypeSafe — модель другого класса. Разработчики называют её System One: быстрые структурированные решения, которые код использует напрямую.
Она не пишет ответов, кода и объяснений. Она возвращает типы и вероятности.
Вопросов три вида:
- noul — «да или нет», ответ — вероятность от 0 до 1;
- choice — выбор из вариантов и уверенность в нём;
- score — оценка по шкале и уверенность в ней.
Девять вопросов за один запрос
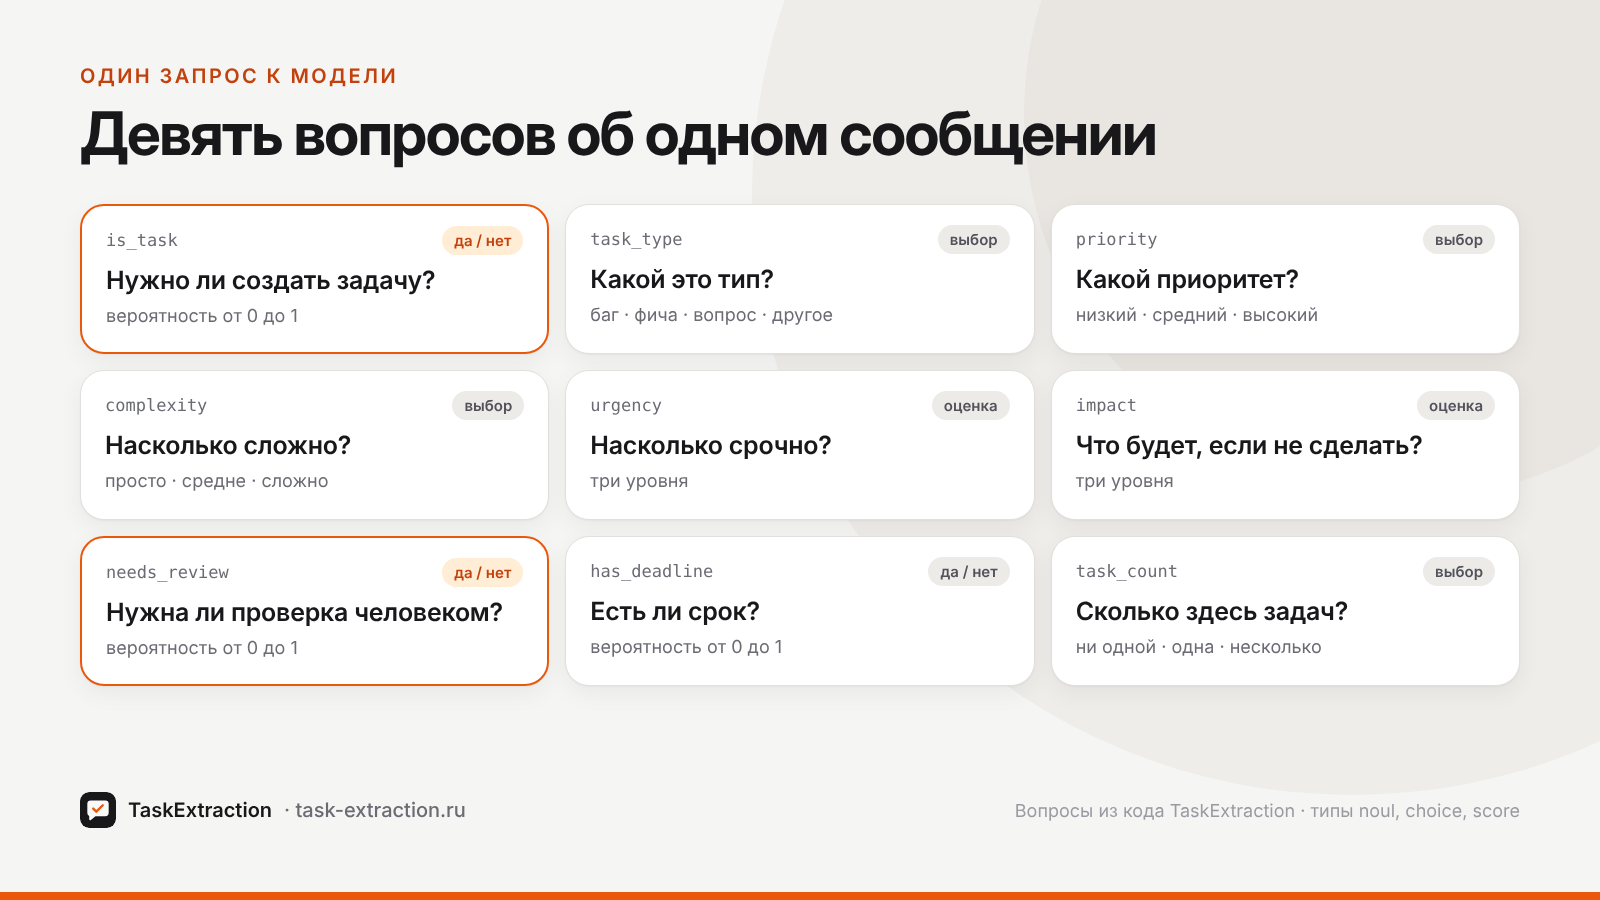
Все вопросы уходят одним запросом и считаются параллельно и независимо друг от друга — так сказано в документации.
Поэтому я спрашиваю сразу всё, что нужно для карточки: задача ли это, тип, приоритет, сложность, срочность, влияние, есть ли срок, сколько задач в сообщении и нужна ли проверка человеком.
К каждому варианту — критерий обычными словами. Высокий приоритет: «блокирует работу, клиентов, деньги или требует реакции сегодня».
На вход — само сообщение и два предыдущих из чата. Подключено через OpenRouter.
Порог — это не одно число
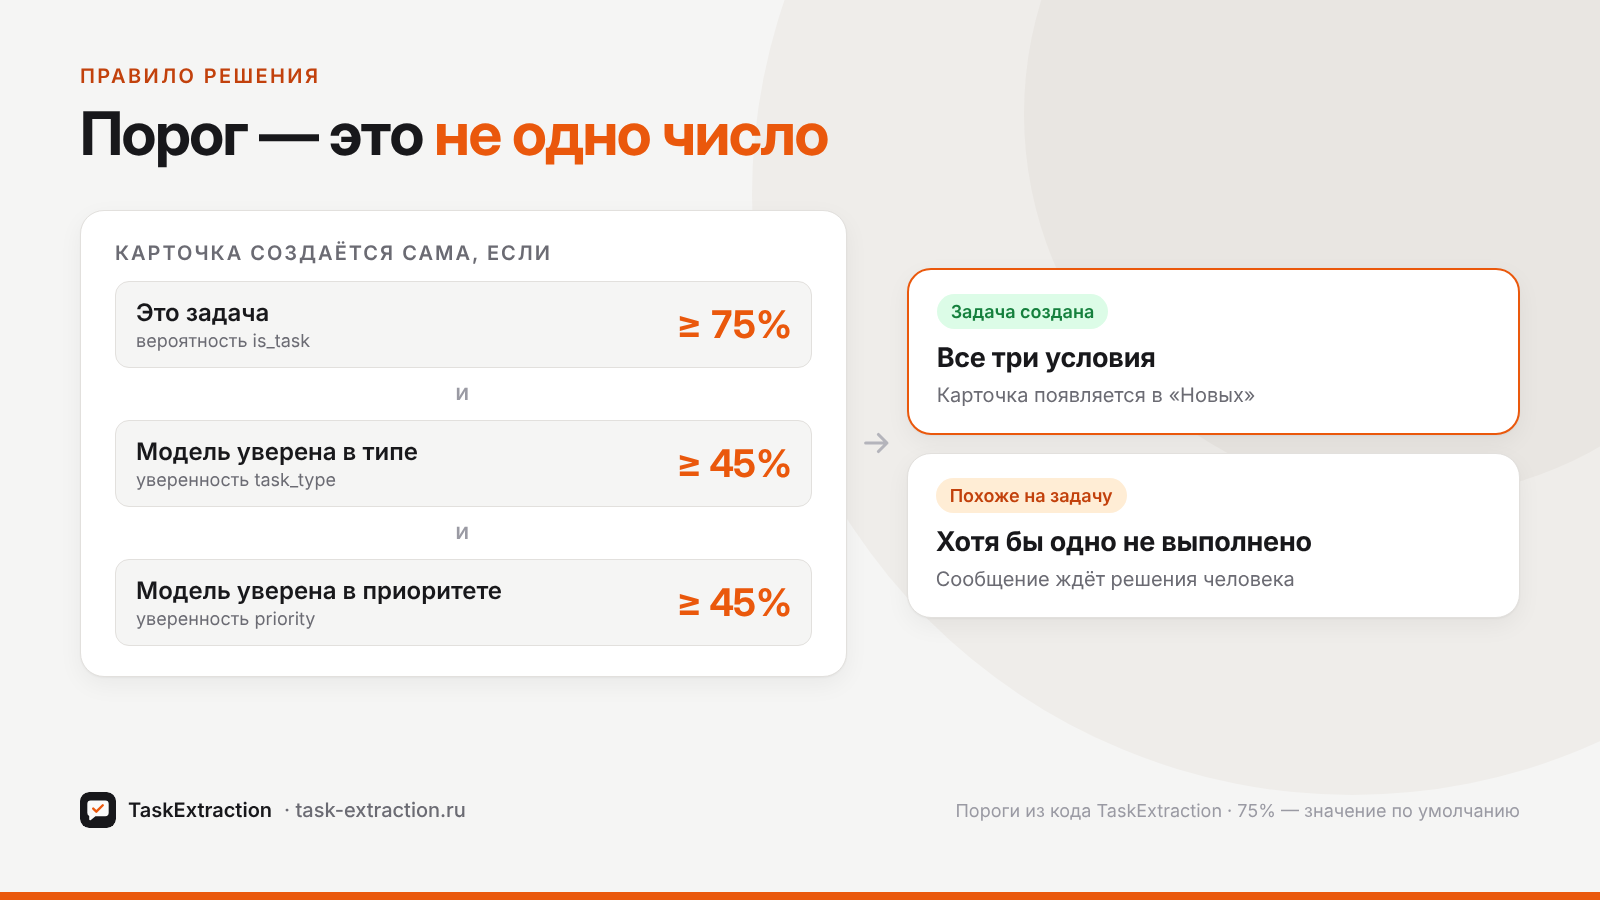
В документации TypeSafe есть фраза, которую стоит повесить на стену: «A confidence threshold is not one number».
У меня так и вышло. Карточка создаётся сама, только если сошлись три условия: вероятность задачи не ниже 75%, уверенность в типе и в приоритете — не ниже 45%.
Не сошлись — сообщение получает пометку «Похоже на задачу» и ждёт человека.
А если модель сама считает, что нужна проверка, или видит в сообщении несколько задач, решение помечается как требующее взгляда. Создание карточки это не блокирует: явный сбой должен дойти до доски.
Jev решает. Обычная LLM пишет
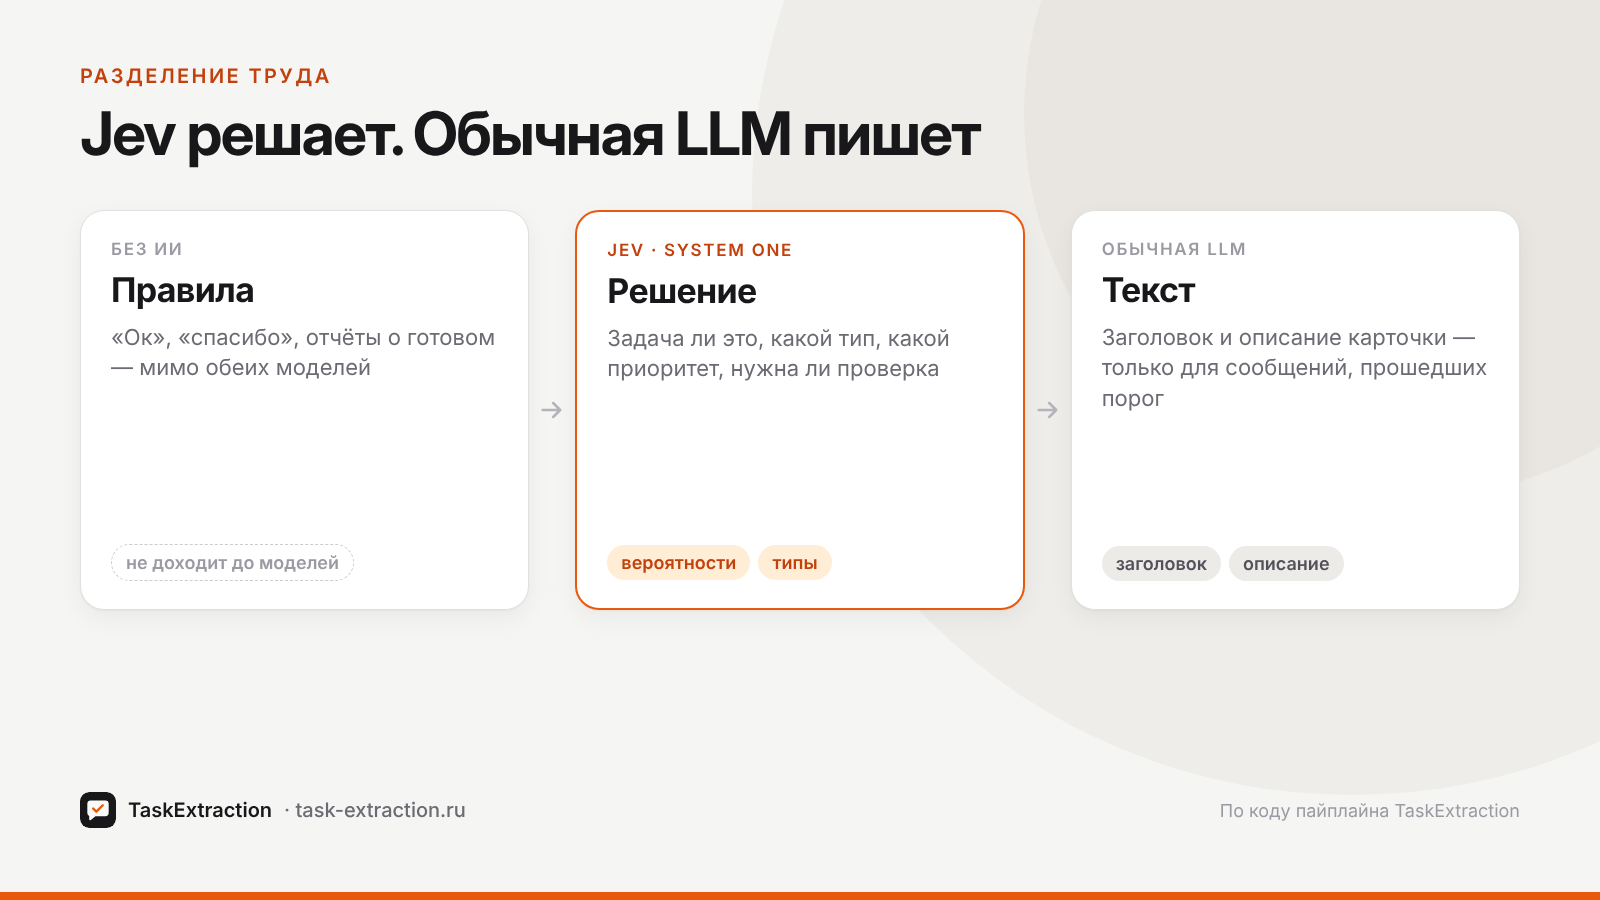
Jev не умеет писать. А карточке нужен заголовок.
Поэтому моделей две. Jev решает, быть ли задаче. Обычная LLM пишет заголовок и описание — только для тех сообщений, что прошли порог.
А «ок» и «спасибо» не доходят ни до одной: их отсекают правила.
Что стало хуже
- Нет объяснений. Jev не говорит «почему». Вместо текста в ленте теперь видны сами вероятности.
- Только текст. Картинки и голосовые модель не принимает.
- Ещё один внешний сервис. Если он не ответил, срабатывает запасной путь — старый классификатор.
- Пороги подобраны руками. В документации советуют начинать с консервативных значений и подстраивать их на своих данных.
В итоге
Я перестал просить нейросеть писать то, что потом сам же разбирал.
Теперь одна модель отвечает числом. Другая — текстом. Каждая делает то, что умеет.
Посмотреть вердикт на своём сообщении: task-extraction.ru — на главной есть демо.